 AI智能体专区

 立即体验恒脑安全智能体



 立即解锁AI安服数字员工


 行业解决方案
 技术解决方案
当AI开始批量喊“狼来了”:公开PoC失真的时代,零日雷达把“验证”做在了告警之前

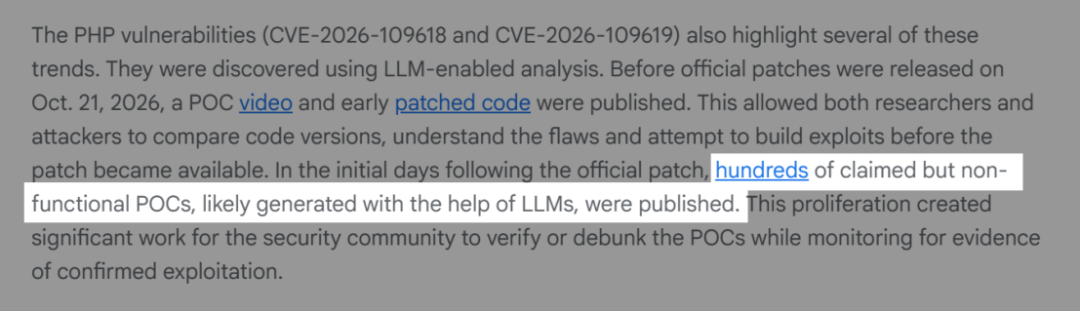

据Google威胁情报组(GTIG)披露,PHP的一组双漏洞(CVE-2026-109618 / CVE-2026-109619)官方补丁于10月21日发布后,数百个疑似由LLM生成、“声称有效、实则无用”的PoC被陆续放出,并在各个社交平台之间来回流转。一个补丁后面,跟着几百条真假难辨的PoC。信号被噪音淹没,甄别真伪,成了防御者新的负担。于是,安全团队要直面的问题也从“看见PoC要不要当回事”,变成了“看见的PoC到底是不是回事”。
要理解这种新负担从何而来,得先看AI为什么会批量制造“看起来能用”的PoC。
先抛开那些故意放烟雾弹、蹭漏洞流量的动机不谈——很多时候,AI不是存心骗人,它是真的“管不住自己”。
首先从背后的逻辑进行分析:大模型写这类攻击代码,追求的是“看起来像一段有效的Exploit”,而不是“真的能打穿目标”。它背后没有一台真实的服务器供它反复试错,也没有任何反馈告诉它“这条路走不通”。于是它写出来的东西:格式正确、术语规范、读起来头头是道——可真拿去用,攻不进去。这就是典型的“一本正经地胡说八道”。
但真正麻烦的,还不只是“假PoC变多”,而是这背后一笔算得出来的成本账。过去PoC稀缺,出现即强信号;现在一个补丁后面跟着几百条,真假比例未知。摆在安全团队面前的只有两条路:要么逐条验证——每一条都得搭环境、跑流量、比对利用条件,这是小时级的人力消耗;要么在甄别完成之前,索性先全部按“可能已被利用”来处置,徒增一堆高优先级告警。而站在对面、把假货批量丢出来的那一方,成本几乎是零。
一边是零成本的制造,一边是小时级的甄别。
这种不对称一旦成立,防御方就被拖进了一场必输的消耗战。换句话说,这场消耗战的关键,不在于告警有多少,而在于“甄别”被谁承担、又在什么时候承担。
既然真正消耗防御方的,是“甄别”这道工序,那么把它提前完成、替客户做掉,就是价值的落点。也就是说,不是让防御者更快地甄别,而是让甄别发生在告警之前。
安恒信息推出的零日雷达,做的正是这件事:从多源接入,到多维研判,到机理推理与动态验证,再到规则生成,最终输出一份带完整证据链的漏洞情报——这是一条端到端打通的链路,中间没有哪一个环节是靠“猜”的。
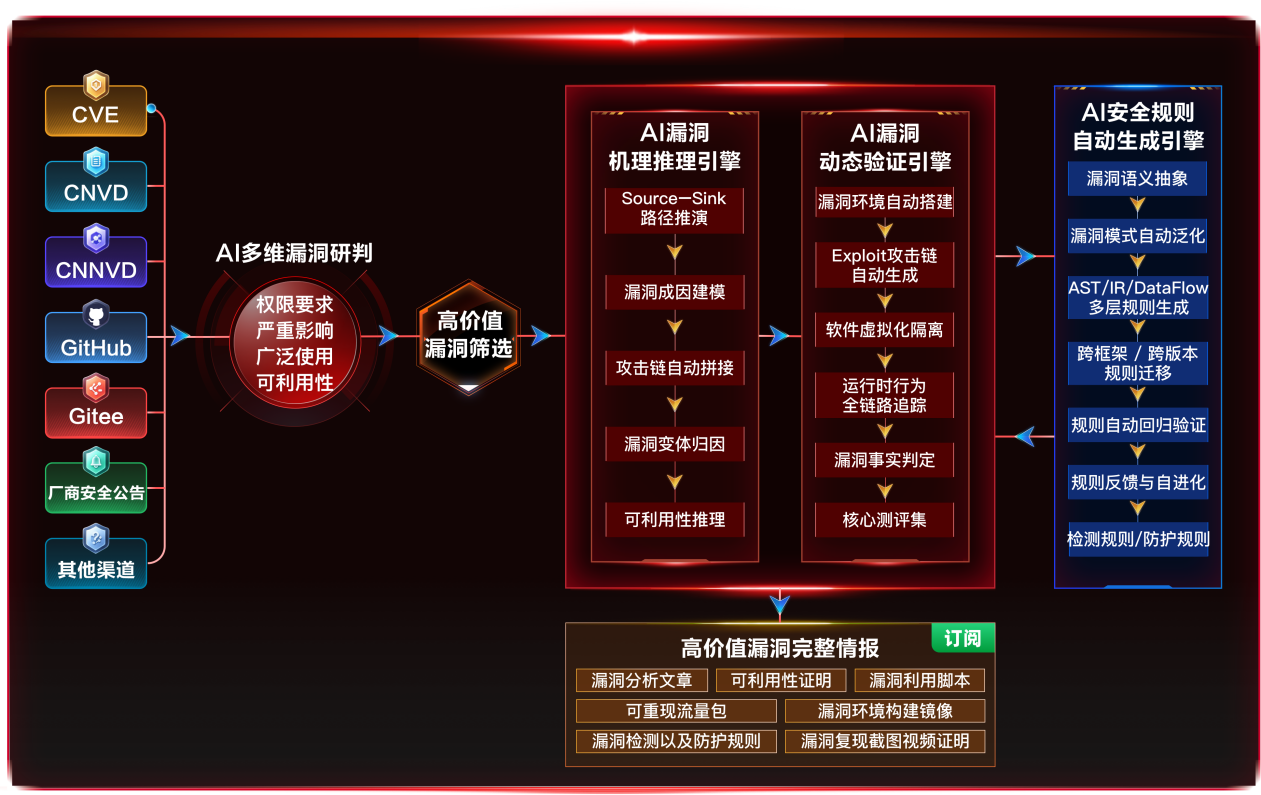
而让“真实可靠”真正落地的,是其中的动态验证引擎。它把验证拆成了实实在在的四步:
第一步,漏洞环境自动搭建。不对着代码纸上谈兵,而是把存在漏洞的软件环境真实地搭起来,让漏洞进入可被触发的状态。
第二步,Exploit攻击链自动生成,并在软件虚拟化隔离环境中执行——在安全的沙箱里真刀真枪地打一遍,而不是停留在纸面推演。
第三步,运行时行为全链路追踪。攻击有没有真的触发漏洞、系统行为是否符合预期,全程留痕、有据可查。
第四步,漏洞事实判定。能不能打通、影响几何,由真实运行的结果说了算,而不是由“看起来像不像”说了算。
总结来说,零日雷达交付的每一条情报,不是“推断”出来的,是在真实环境里“跑”出来的。再配合机理推理引擎的成因分析、规则自动生成引擎的防护落地,最终交到客户手里的,是一份可直接用于处置的高价值漏洞完整情报。
回到开头的问题:公开渠道的PoC只会越来越多,真假只会越来越难辨。说到底,线索从来不缺,缺的是经过验证的那一份。零日雷达把甄别与验证前置,交付可追溯、可复核的漏洞情报。把判断的苦活累活留给我们,把一个确定的结论,留给每一位看情报的人。
*参考文献:Google Threat Intelligence Group (GTIG),《AI Threat Tracker: Agentic Threat Activity Crosses a Significant Threshold》,2026年11月16日。