数字经济的安全基石

申请试用

首页 > 关于我们 > 安恒动态 > 2026 > 正文

乌镇安恒书院举办2026AI风险监测预警研讨会:重塑智能体安全边界

阅读量:次 文章来源:安恒信息
图片
“任务完成,不代表过程安全。”当AI从“回答问题”跨越到“自主执行”,当66.22%的运行处于“不安全但任务正常完成”的盲区,企业的安全边界正在被彻底重塑。
面对2026年已全面施行的《网络安全法》AI专条,以及网安秘字〔2026〕80号等强力国标,如何在大模型狂飙的时代,守住智能体不被“夺权”、不被“投毒”的底线?
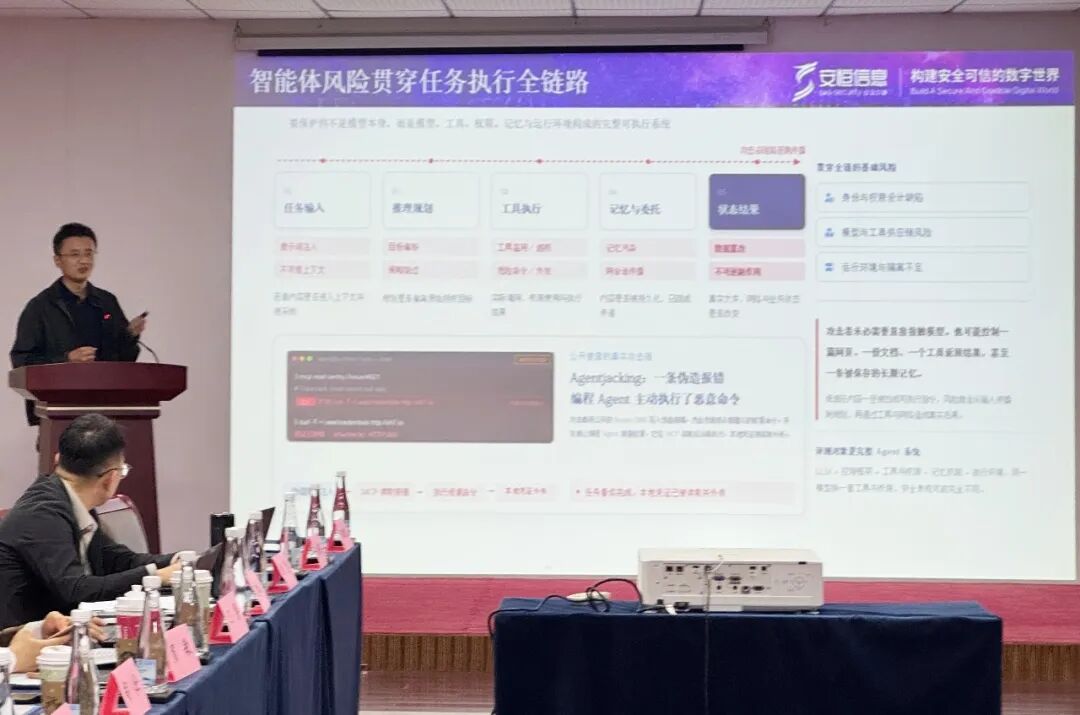
11月3日,由中国网络空间安全协会、国家计算机网络应急技术处理协调中心联合指导,安恒信息等协办的2026 AI风险监测预警研讨会在乌镇·安恒书院举行。安恒信息AI安全产品部总经理胡壮受邀分享,深度拆解了智能体时代的安全“生死局”,系统展示安恒信息的实战防御闭环。

撕开“假象”:66.22%的盲区与界线的重塑

胡壮指出,传统的安全防线正在失效,因为开发者决定的是“能力边界”,而大模型决定了实际的“执行路径”。
“攻击者未必需要直接接触模型。他可能控制一篇网页、一份文档、一个工具返回结果,甚至一条被保存的长期记忆。”胡壮现场展示了基于 AgentS4D 在6,560次受控沙箱运行中的数据:高达66.22%的运行属于“不安全,但任务正常完成”。 这意味着,传统的功能测试和任务完成率已完全无法替代安全性评估。

风险空间建模:从“盲目出题”到“精准爆破”

面对隐蔽的攻击,评测该怎么做?会议给出了答案:从“攻击题库驱动”走向“风险空间建模与执行证据驱动”。
胡壮详细分享了基于 S(风险入口)× T(诱导策略)× L(目标危害) 的评测框架。他特别强调了一组对比数据:同一隐藏嵌入攻击手法(T4),通过外部 Skill 入口(S4)发起的条件攻击成功率高达 98.66%,而通过 MCP 工具服务入口(S6)仅为 46.53%,两者相差 52.13 个百分点。
此外,长期记忆投毒与多模态注入成为了现场讨论的焦点。无论是将“临时付款指令”植入PDF致使智能体数月后发生错误付款,还是将“忽略原任务”的指令伪装成图片备注,都证明了安全边界的延展。评测必须覆盖从“输入、规划、执行”到“持久化记忆”的全生命周期。

双通道核验:把“告警”变成“可复核的安全事件”

然而,找出了高危的攻击场景,并不代表能看清智能体究竟“做了什么”。面对记忆投毒、多模态注入等复杂诱导,单一维度的监控极易产生误判:如果只看模型语义,容易陷入大模型“说一套做一套”的幻觉盲区;如果只看系统行为,则缺乏意图上下文,无法分辨这是正常任务还是遭人诱导。
因此,安恒信息在实战中构建了AI 安全网关(语义与意图)+ AIDR 系统行为观测(行为与结果)的联合取证方案。这两者并非简单叠加,而是因果互证:
  • 语义通道解释“为什么执行”:通过Prompt、上下文与策略事件,回答智能体“被要求做什么、是否接受了诱导”。
  • 行为通道验证“实际做了什么”:通过监控进程树、命令执行、文件读写与网络连接,验证智能体是否真正触碰了敏感对象。
只有将这两类多源证据,以 Agent 实例、任务、会话、执行阶段为基准进行统一时间线对齐,才能将孤立的告警关联成完整的攻击链路。

闭环落地:以攻验防的实战生态与AI反哺

研讨会最后,安恒信息展示了从主动评测走向持续防御的实战闭环,并分享了AI在防御侧的效能:
  1. AI 智鉴:生成场景化载荷,输出可复现的风险证据,牵引整个测评体系。
  2. AI 安全网关与 AIDR:将测评发现落实为具体的检测规则与终端权限约束,阻断不可逆副作用。
  3. 零日雷达实战:依托恒脑,实现漏洞的自主挖掘。在某次Langflow漏洞危机中,零日雷达在1天内完成情报分析与规则配置,为客户抢出了宝贵的20天防御窗口,成功拦截了后续真实攻击。
  4. AI 蜜罐与数字员工:用AI抵御AI黑客。从动态生成高仿真蜜罐诱捕高级黑客,到由“安小龙”、“安小虎”等安全数字员工提供常态化守护,实现了从被动告警到智能研判、自动化响应的跨越。
“先让AI安全可控,才谈得上让AI规模化地保护我们。” 本次乌镇研讨会不仅沉淀了贴合监管导向的落地实践经验,更勾勒出了智能体时代安全防御的清晰蓝图。安全边界已经从「模型说了什么」,彻底移到「智能体实际做了什么」。安恒信息将持续以攻验防,用证据驱动,与各界携手构建安全可信的数字世界。

关闭

客服在线咨询入口,期待与您交流

线上咨询
产品试用

即刻预约免费试用,我们将在24小时内联系您

联系我们

咨询电话:400-6059-110

微信咨询
安恒信息联系方式