数字经济的安全基石

申请试用

首页 > 关于我们 > 安恒动态 > 2026 > 正文

西湖论剑丨张向宏:“数据工厂——人工智能下半场竞争的关键选择”

阅读量:次 文章来源:安恒信息
图片

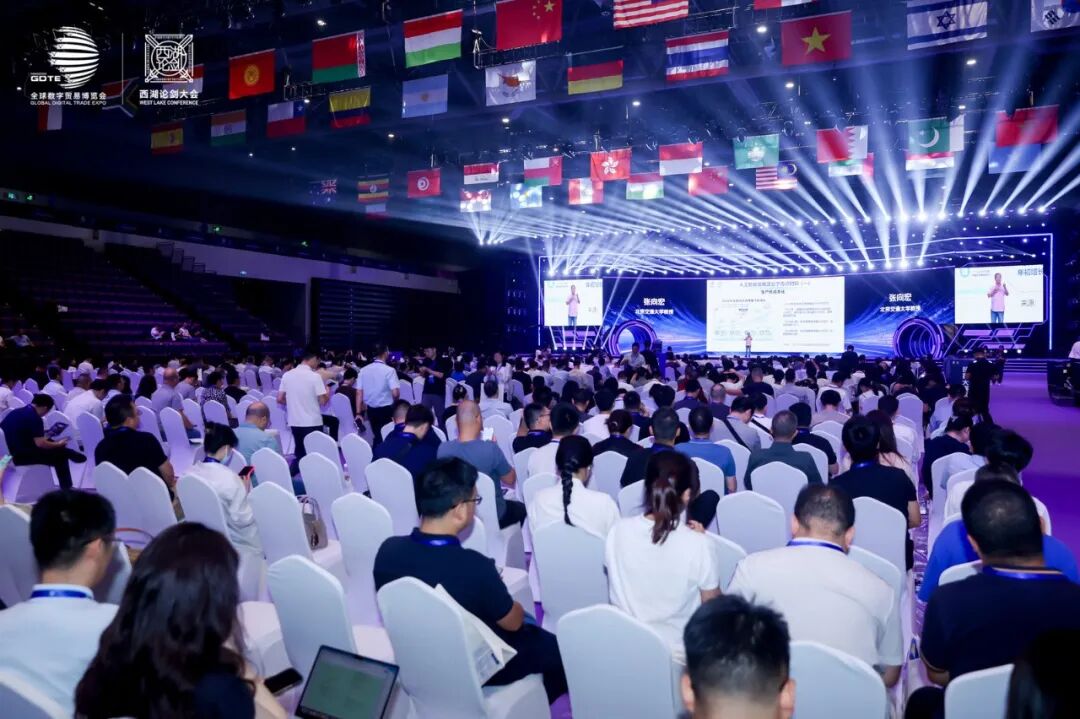
9月23日上午,在2026全球数贸会·西湖论剑大会主论坛上,北京交通大学教授张向宏围绕人工智能与数据要素发展的5个核心问题,进行了“数据工厂——人工智能下半场竞争的关键选择”的主题分享。


他的判断是,人工智能正处于“奇点时刻”。全国词元调用量从2024年初的1000亿跃升至2025年底的100万亿,2026年3月突破140万亿,6月突破500万亿;人工智能数据应用总量达199.48EB,其中推理数据量101.34EB,首次超过训练数据量;系统软件与人工智能产生的数据量达26.92ZB,首次超过物联感知数据的25.34ZB。在他看来,这意味着“人工智能毕业了”,而且深度嵌入了日常工作、生活和学习。

但问题在于,人工智能应用增长速度虽然很快,却远远谈不上深入应用:相对成熟的只有文书、编程两个行业,成千上万的行业仍在门外。“数据成了人工智能关键的瓶颈。”他把产业链拆成四段:通识数据集训练通用大模型,行业通识数据集训练行业大模型与世界模型,行业专识数据集训练智能体与具身智能,最终通向千行百业——而“我们目前在第一个环节”。


如何来理解?他用通识教育打比方:通用大模型靠公域数据训练,如同人只受过小学到高中的通识教育,教材一样,能做的事有限,高考状元做不了外科手术;行业大模型、智能体与具身智能,才是千行百业真正的载体。约束来自数据本身:互联网上可流通的格式化数据只有4%,另有16%的非结构化数据虽不涉隐、不涉密却难以流通,其余大部分长期“管起来不能动”。通用大模型几乎耗光那4%之后,必须同时向广度与深度拓展。


对此的破解之道是建设数据工厂。“农业社会有农场,工业社会有工厂……数据工厂是生产高质量数据集的。”他解释,大规模的原始数据进来,大规模体系化、规模化、设施化、标准化的高质量数据集出去,为人工智能提供源源不断的燃料。数据工厂由储备、生产、中试三个车间构成,承担从采集、清洗、标注到模型训练评估的全流程,并具备多样化、规模化、设施化、标准化、AI化五个特征。研究源自国家数据局委托课题,团队已发布《数据工厂白皮书》,数据工厂也已列入明年标准计划,预计出台总体框架、技术要求与评估规范。

具体来说,建设数据工厂需分类施策,三类工厂对应12种模式:通识数据集数据工厂靠开源社区获取、互联网自主采集、购买版权获取;行业通识数据集数据工厂由技术企业创新创立、传统企业延伸、数据中心升级、数据共享开放运营四种路径构成;行业专识数据集数据工厂则包括智能体企业和传统企业向上游延伸、本体遥操作、非本体采集、仿真与合成、视频与开源获取五类方式。其中,具身智能数采工厂今年兴起,全国已有106家。


面向未来,他凝练出九大趋势:数据版权化、数据公域化、形式多样化、数据本体化、加工智能化、模数共振化、行业通识数据规模化、生产低成本化、数采方式融合化。数据免费的时代正在结束,大模型爬取互联网数据面临的法律挑战日益严峻;与之相向而行的,是公共数据与行业数据集的持续开放。他强调的“模数共振”,指数据治理、加工、标注很难孤立推进,必须面向场景形成高质量数据、训练高质量模型,再回到有价值场景产生新数据——目前国家数据局与工信部已选择20个行业打造30个场景。成本也是关键变量:人形机器人数据采集每小时需500至1000元,与通用大模型时代的数据免费形成鲜明对照;世界模型则有望成为具身智能的基座。


“人工智能到了一个非常关键的时候。”张向宏说。上半场拼的是算力与模型,下半场的胜负手,很可能是谁能把数据从“原材料”变成“生产资料”——数据工厂,正是这场转换的入口。


关闭

客服在线咨询入口,期待与您交流

线上咨询
产品试用

即刻预约免费试用,我们将在24小时内联系您

联系我们

咨询电话:400-6059-110

微信咨询
安恒信息联系方式